Risolvere i problemi dei video AI con Seedance: sei sintomi e la riga di prompt che sta dietro a ciascuno
Una diagnosi che parte dai sintomi per i video AI Seedance: cosa indica nel prompt ogni artefatto di una clip finita e la correzione più piccola per eliminarlo.
La maggior parte delle clip Seedance deludenti non è scritta male. È scritta nell'ordine sbagliato, oppure descrive un'atmosfera dove il modello aveva bisogno di un'inquadratura. La parte utile del text-to-video è che una clip finita è anche un referto diagnostico: un fotogramma che si deforma mentre la camera si muove rimanda alla frase sulla camera, un oggetto di scena che cambia tra due inquadrature rimanda a come lo hai nominato, e una battuta di dialogo sepolta sotto sottotitoli indesiderati rimanda al blocco audio. Leggi l'output in questo modo e la maggior parte delle correzioni si riduce a una frase.
Questa è una disamina che parte dai sintomi, non un mucchio di template. Ogni sezione indica qualcosa che puoi vedere nel player, l'abitudine di prompting che ci sta dietro e la modifica più piccola che la elimina. I riferimenti sono le indicazioni di ByteDance stessa per i modelli Seedance e le guide di prompting pubblicate che le mettono alla prova nella pratica.
I prompt Seedance hanno due livelli, e falliscono in modo diverso
La guida di Runway a Seedance descrive il prompt come due livelli che svolgono compiti diversi. Il livello esterno è strutturale: la clip si scompone in inquadrature etichettate, scritte nell'ordine in cui accadono gli eventi, così il modello conosce il ritmo prima di conoscere il contenuto. Il livello interno è descrittivo: dentro ogni inquadratura, frasi continue coprono chi c'è, cosa sta facendo, dove, con quale luce e come si comporta la camera.
Fuser, riassumendo il materiale di ByteDance, assegna al livello interno un ordine che vale la pena memorizzare: soggetto e azione, poi scena e ambiente, poi stile visivo, poi movimento di camera e stacchi, poi suono, con una riga di vincoli alla fine. L'esempio svolto di Runway copre lo stesso terreno in otto elementi e si chiude con qualità, stile e un'istruzione negativa su sottotitoli e filigrane.
Quasi ogni errore qui sotto è uno di quei due livelli che cede. Un prompt senza scaletta di inquadrature diventa un unico vagare indistinto. Un prompt senza descrizione produce fotogrammi tecnicamente in movimento in cui non c'è nessuno che valga la pena guardare. Quando apri una clip sbagliata, decidi prima quale livello stai guardando, perché per ciascuno dei due la correzione sta in una parte diversa del prompt.
Sintomo uno: la clip è bellissima e quasi immobile
Hai chiesto «cinematico, d'atmosfera, molto dettagliato, profondità di campo ridotta» e hai ottenuto una fotografia che respira. Le parole di stile superano quelle di azione quattro a uno, così il modello rende l'aspetto visivo e improvvisa il movimento, e ciò che improvvisa è piccolo e prudente.
La correzione è spendere le parole su una sola azione, con una velocità e una forza, legata a una parte del corpo. L'esempio di Runway fa esattamente questo: una ceramista stabilizza il bordo di una ciotola con entrambe le mani, lentamente. L'avverbio porta il ritmo e le mani portano il movimento, così non resta nulla da indovinare. Se il soggetto è un prodotto invece di una persona, nomina l'unico movimento che compie, come una rotazione di trenta gradi, e di' cosa resta fermo intorno.
Sintomo due: l'inquadratura si piega mentre la camera si muove
È l'artefatto Seedance più comune, e il meno misterioso. Le indicazioni di ByteDance per Seedance 2.0 avvertono che chiedere contemporaneamente una spinta in avanti, un allontanamento, una panoramica e un movimento aumenta l'instabilità dell'immagine. Quattro istruzioni si contendono un solo fotogramma, così i bordi si sbavano, le linee rette si curvano e i volti perdono la loro geometria.
Un solo movimento per inquadratura è la regola, e un secondo movimento appartiene a una seconda inquadratura, non alla stessa frase. Se ti serve una spinta in avanti che si chiuda su un primo piano, scrivi la spinta e lascia che l'inquadratura si assesti, oppure etichetta Inquadratura 1 e Inquadratura 2 e assegna a ciascuna la propria riga di camera. L'altra metà della correzione è nominare la camera con termini cinematografici che il modello già legge: dimensione dell'inquadratura, angolazione e un movimento, invece di un paragrafo di atmosfera che implica il movimento senza specificarlo.
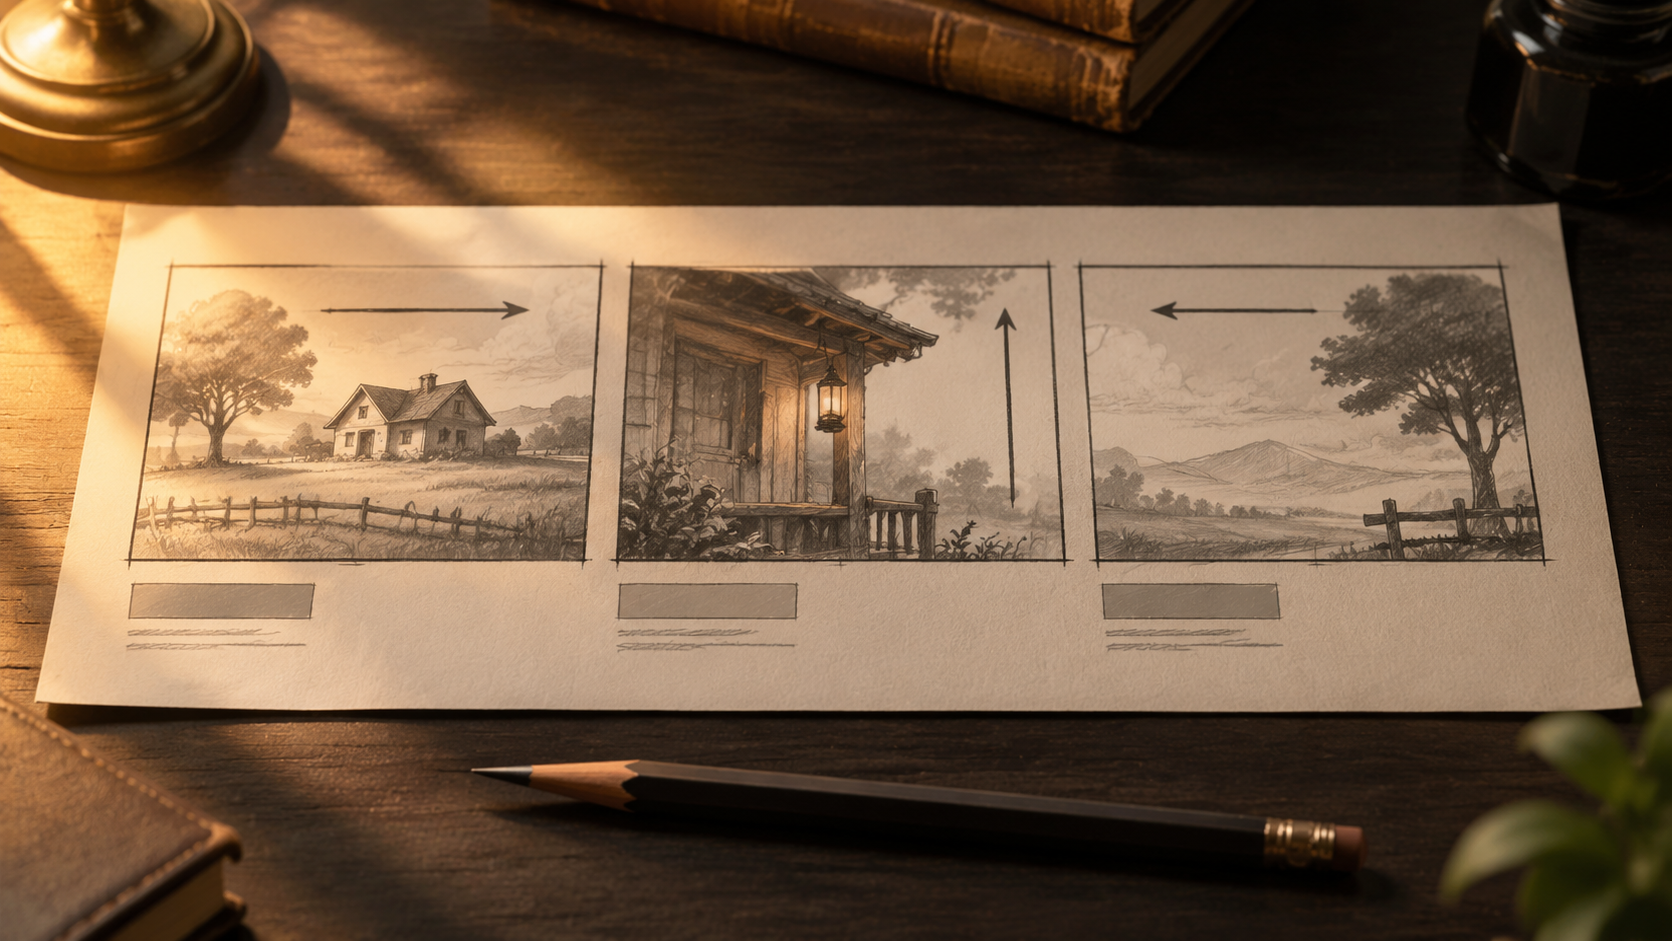
Sintomo tre: gli stacchi arrivano dove non li hai mai chiesti
Un prompt che dice «a due secondi lei si volta, a quattro secondi la camera stacca in campo largo» presume che il modello legga un orologio. La guida di ByteDance per Seedance 2.0 dice che risponde ai numeri delle inquadrature più che alle durate esatte, e avverte che forzare durate precise può portare a risultati di generazione anomali. La generazione 2.5 successiva legge intervalli in secondi interi, come un'inquadratura da zero a due secondi, che è un contratto diverso.
Quindi la diagnosi dipende da quale versione stai usando nel prompt. Se il prompt è pieno di istruzioni secondo per secondo e la clip inventa stacchi in più o si inghiotte interi passaggi, stai sovraprogrammando un modello che vuole numeri di inquadratura. Numera le inquadrature, metti i passaggi nell'ordine in cui accadono e lascia che il ritmo si risolva. Se la tua versione legge davvero i timestamp, mantieni la timeline continua senza buchi ed evita di stipare un intervallo così stretto che il modello debba aggiungere uno stacco per farci entrare tutto.
Sintomo quattro: l'oggetto di scena cambia tra due inquadrature
Il test pubblicato da Fuser è l'illustrazione più limpida disponibile: un vasaio generato in due inquadrature, con il vaso come ciotola bassa e aperta nel primo piano e come cilindro alto nel piano medio. Il prompt cambiava la descrizione dell'oggetto tra un'inquadratura e l'altra senza accorgersene.
La soluzione è una disciplina di denominazione. Descrivi l'oggetto una volta, con le stesse parole, ovunque compaia, e preferisci un inventario concreto a un aggettivo: l'archetto, due padiglioni, la smaltatura opaca color avena, il bordo sinistro scheggiato. Dove l'oggetto conta commercialmente, allega un'immagine di riferimento e specifica cosa controlla, invece di sperare che la prosa tenga. La guida di Runway aggiunge un punto correlato per le persone: un'unica immagine combinata che contiene volto, abbigliamento, posa e sfondo dà ai tratti del viso una porzione di fotogramma troppo piccola per ancorarsi, quindi un riferimento per il volto deve essere prima di tutto un riferimento per il volto.
Sintomo cinque: il passaggio emotivo si svuota
Hai scritto «sembra orgogliosa» e hai ottenuto un volto neutro con una pelle perfetta. Parole come orgogliosa, triste e nervosa descrivono uno stato interiore; non c'è nulla in esse che un renderer possa collocare. Le indicazioni di Runway sono dirette su questo punto: mostra l'emozione come comportamento fisico.
Riscrivi il passaggio come un'azione visibile con un inizio e una fine. Le spalle si abbassano. Lui espira e distoglie lo sguardo dall'obiettivo. Lei si ferma a metà gesto e la mano si posa sul tavolo. La stessa regola salva il video di prodotto: «premium» non è renderizzabile, ma una lenta passata di luce su un bordo in metallo spazzolato sì.
Sintomo sei: il dialogo arriva sotto sottotitoli che non hai ordinato
Nelle generazioni Seedance che producono l'audio nello stesso passaggio dell'immagine, il suono appartiene al prompt invece che a un blocco separato aggiunto dopo. Fuser registra la convenzione di parentesi di ByteDance: parentesi angolari per gli effetti, parentesi graffe per il dialogo, parentesi tonde per la musica, con la lingua indicata prima di una battuta non in cinese.
Due abitudini causano il problema dei sottotitoli. La prima è ripetere parole del dialogo o etichettare singole parole con un'emozione, cosa che le indicazioni elencano come innesco di testo indesiderato sullo schermo. Aggancia la nota di interpretazione a chi parla, non alla battuta. La seconda è lasciare impliciti i vincoli: chiudi il prompt con un'istruzione semplice che la clip resti senza sottotitoli e senza loghi o filigrane, e tieni del tutto fuori dal prompt la tipografia densa, ricostruendo le didascalie in montaggio, dove si possono correggere senza un nuovo render.
Correggi nell'ordine giusto quando compaiono più sintomi
Cambia tutto in una volta e non impari nulla, perché non puoi attribuire il nuovo risultato a una singola modifica. Lavora invece in questo ordine.
Parti dall'identità: il soggetto, gli oggetti di scena e la frase sui tratti che li protegge. Se il soggetto non è stabile, nulla di ciò che viene dopo è verificabile. Poi la camera, perché un fotogramma che si deforma maschera ogni altro problema. Poi tempi e numero di inquadrature, dato che il numero di stacchi determina lo spazio che l'audio ha a disposizione. Infine suono e vincoli.
Dove l'interfaccia espone un seed, tienilo fisso per tutta la sessione di correzione, così il confronto isola la tua modifica e non il campionatore. Genera corto, rivedi, e allunga la durata solo quando la versione da cinque secondi regge; la clip più lunga conserva più stato, e una lunga sequenza fallita spreca un'unità di lavoro più grande.
Una checklist pre-render che vale trenta secondi
- Il soggetto è nominato una volta e indicato con la stessa etichetta in tutto il prompt.
- Ogni inquadratura ha esattamente un'azione, scritta con una velocità e una forza.
- Ogni inquadratura ha esattamente un movimento di camera, in termini cinematografici.
- Le inquadrature sono numerate nell'ordine in cui accadono gli eventi.
- Gli oggetti che compaiono due volte sono descritti in modo identico in entrambe le occasioni.
- L'emozione è scritta come comportamento fisico.
- Il suono sta nelle sue parentesi, con la lingua indicata.
- L'ultima riga rimuove sottotitoli, loghi e filigrane.
Metti alla prova la disamina su una clip reale
Il senso di una disamina diagnostica è che rende il secondo render più economico del primo. Smetti di riscrivere l'intero prompt e inizi a modificare una frase, poi confronti le due clip affiancate sul sintomo che stavi inseguendo. Due o tre cicli di questo tipo di solito producono una clip che tiene insieme, e un prompt che puoi riusare per il prossimo prodotto o la prossima scena.
Puoi applicare la disamina al generatore di video Seedance di KOOX, partendo da una durata breve e da una sola inquadratura prima di impegnarti in una sequenza più lunga con stacchi. Tieni affiancati la versione del prompt, le impostazioni e la nota di revisione: così lo schema di quale frase causa quale artefatto diventa tuo, invece di qualcosa che devi ricavare ogni volta da capo.