图生视频提示词:一套能适配任何静帧的五句骨架
图生视频提示词的五句骨架——锚定、动作、运镜、节奏与冻结清单——附四类源图的实操示例,以及按症状对症的修复指南。
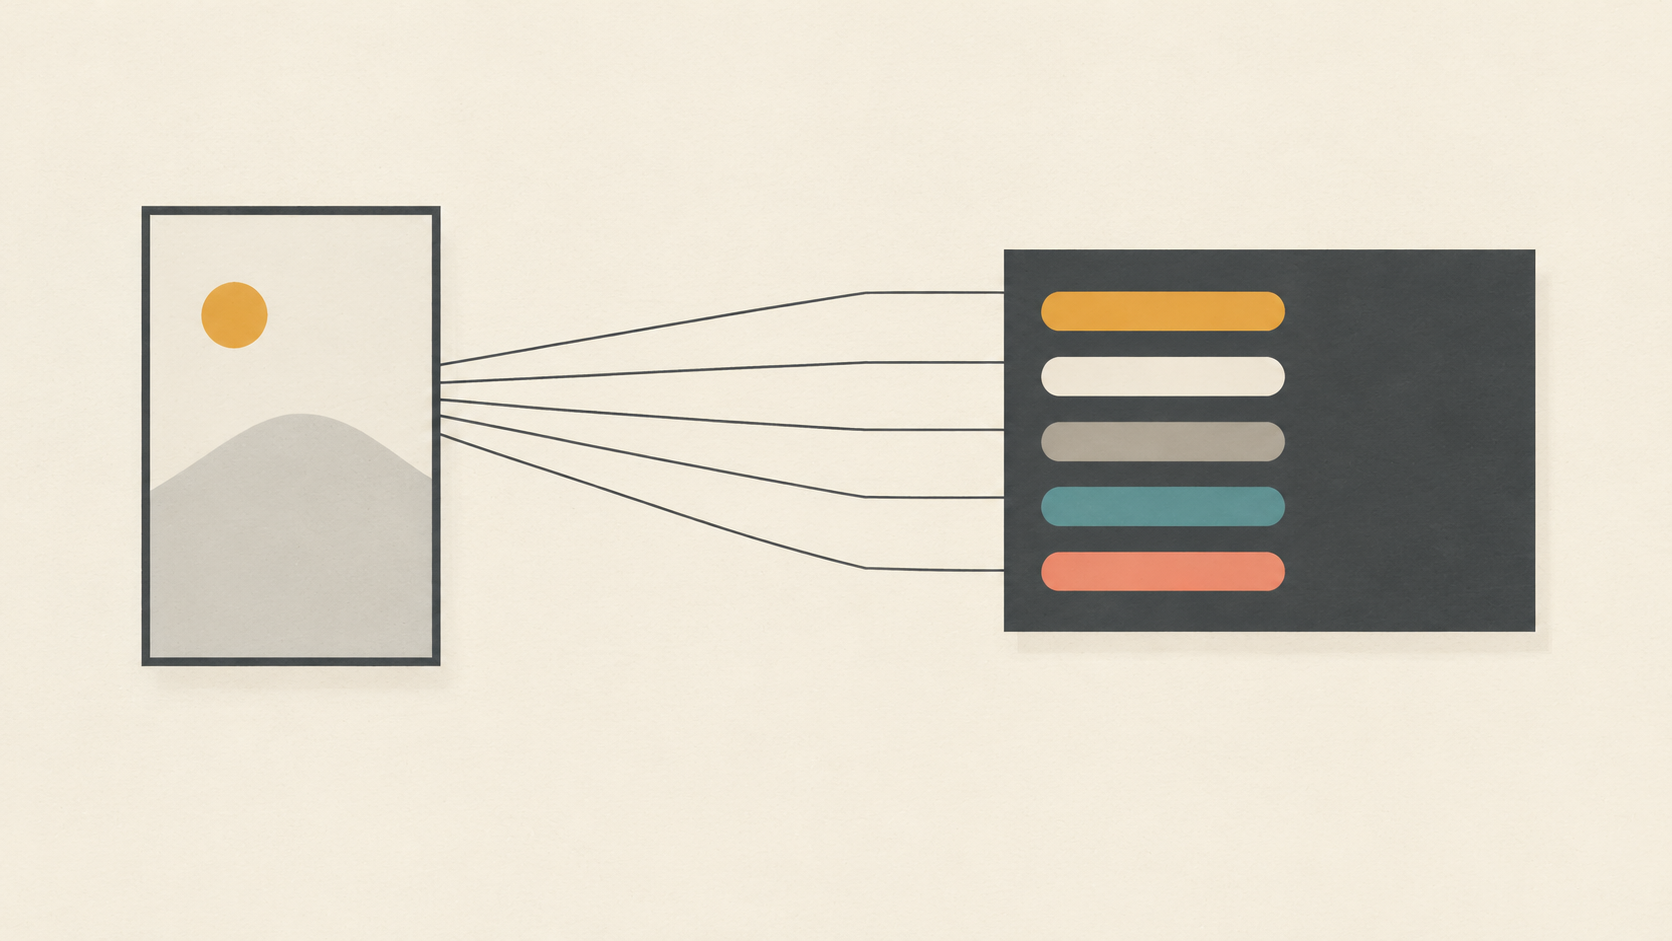
图生视频提示词不是对场景的描述。场景已经在你屏幕上了:外套的颜色、窗户的光线、杯子的形状、确切的裁切。静帧无法告诉模型的是接下来该发生什么,而这恰恰是唯一值得花笔墨的地方。
大多数令人失望的片子,都来自把照片反过来描述给模型的提示词。十个形容红衣女子的形容词,并不能给生成器任何可动的对象,于是它自己补上了漂移、自己补上了推镜、自己补上了缓慢的晃动。真正立得住的提示词更短、更有结构:一句锁定画面,一句点明一个可见动作,一句做出运镜决定,一句设定节奏,一句列出不能改变的东西。
静帧已经决定了什么
一张源图到手时,提示词的大部分已经有人替你回答了。主体已选定,光线已有方向,构图已有裁切,色调已经固定。Kling 的提示词指南给出一个六段式框架——主体、动作、场景、运镜、光线、氛围——而当你要让一张静帧动起来时,这六项里有四项已经在文件里看得见。真正开放的只有动作和运镜,而氛围通常由你反正也改不了的光线暗示出来。
这就是为什么图生视频的提示词应该比文生视频的短得多。Founderz 的提示词库从相反的方向提出了同样的要求:一条好的 AI 视频提示词要点明一个可见动作、镜头与运镜、光线、时长,以及不能改变的东西。在静帧上,光线是给定的。其余四项归你。
所以,把提示词当成一份运动预算。你花在复述画面上的每一句,都是从变化上挪走的一句,而模型会用泛化的运动来填补这个空缺:没人要求的缓慢推镜、扫过整个画面的微光浮动、本该静止却开始呼吸的主体。
五句骨架
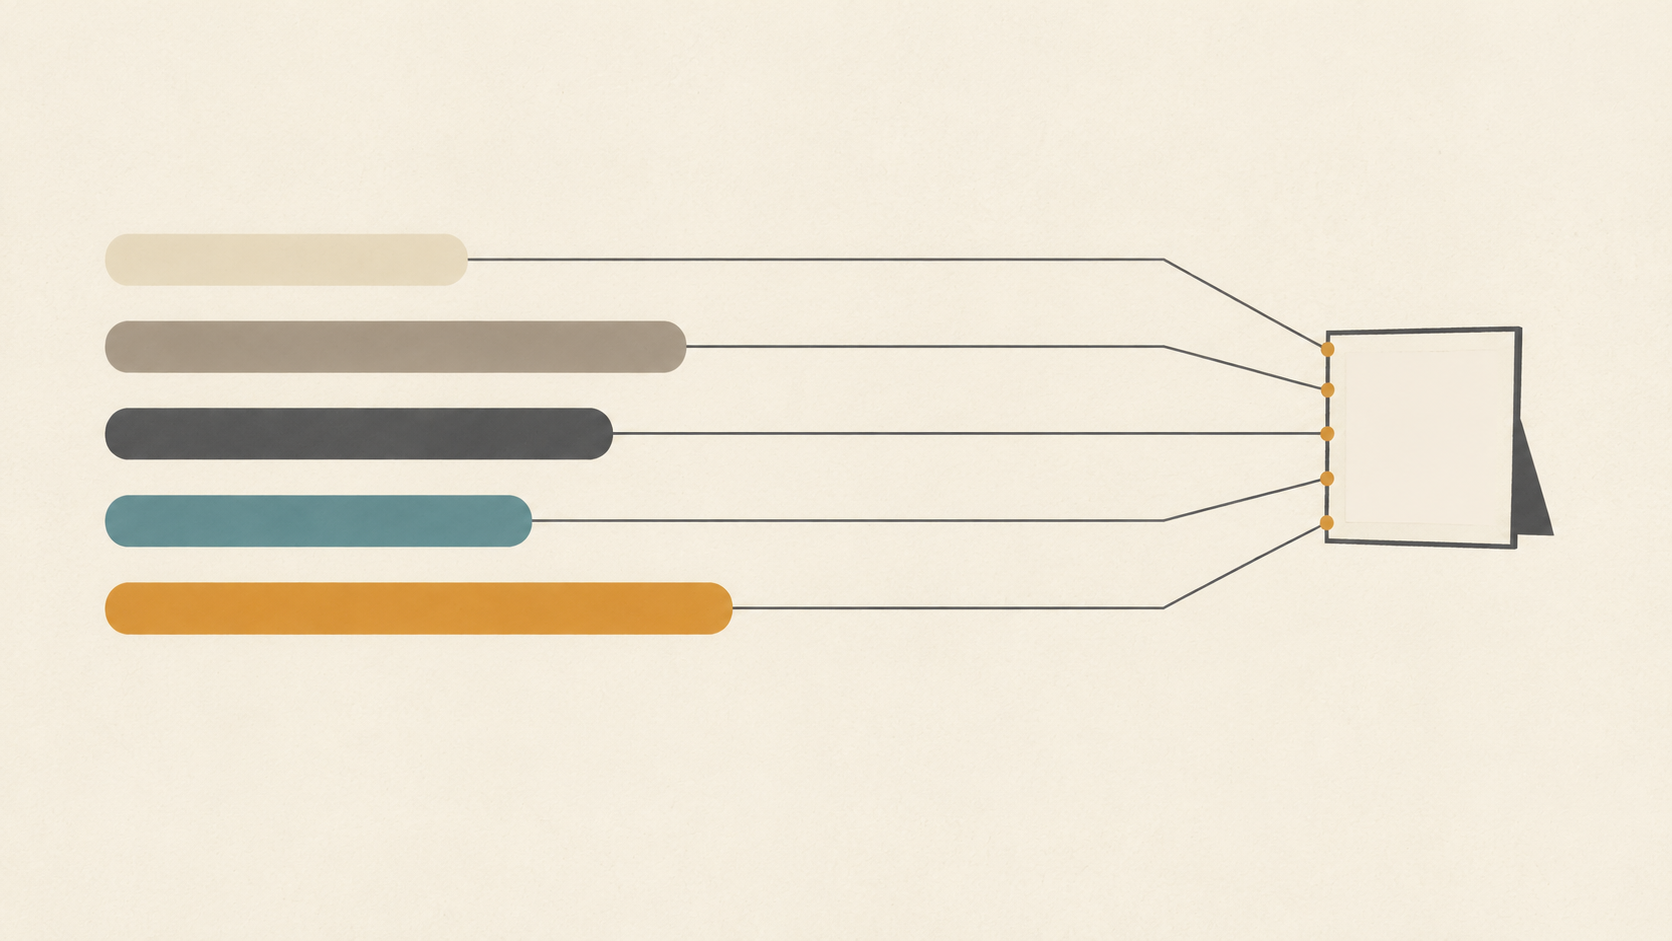
按这个顺序写五行。合起来大约 40 到 60 个字,正好是几秒钟短片的体量。
- 锚定。 锁定模型不许重新设计的东西:“与源图相同的取景、相同的镜头、相同的光线。”没有锚定,模型会把照片当成一个建议并重新构图,裁切对不上、地平线漂移就是这么来的。
- 动作。 一个可见的动词,绑定一个主体:“她朝窗户方向转了几度头,然后停住。”一个动作,不是一串动作。一条短片里塞两个动作,通常两个都做不完。
- 运镜。 点明一种运动及其幅度:“缓慢推近,结束时比开头近约 10%,以标签为中心。”如果这个镜头不需要运镜,就明说——“固定机位”是有效而且往往更好的指令。
- 节奏。 把动作绑在时间上:“第一秒几乎不动,转头在第三秒前完成,最后一秒保持。”模型默认会把运动摊到整条片子上,看起来就是持续的缓慢漂移;给它一份时间表,运动才显得是有意为之。
- 冻结清单。 那些不能改变、也不能出现的东西:“标签始终朝向镜头并保持清晰,没有手进入画面,没有新物体,嘴保持闭合。”否定式的要求只有在具体时才起作用。
按顺序读完这五行,你就得到了一份能塞进一条短信里的镜头方案。打乱顺序读,或者漏掉一句,你通常就能预判自己会得到哪种失败。
四张照片,一套骨架
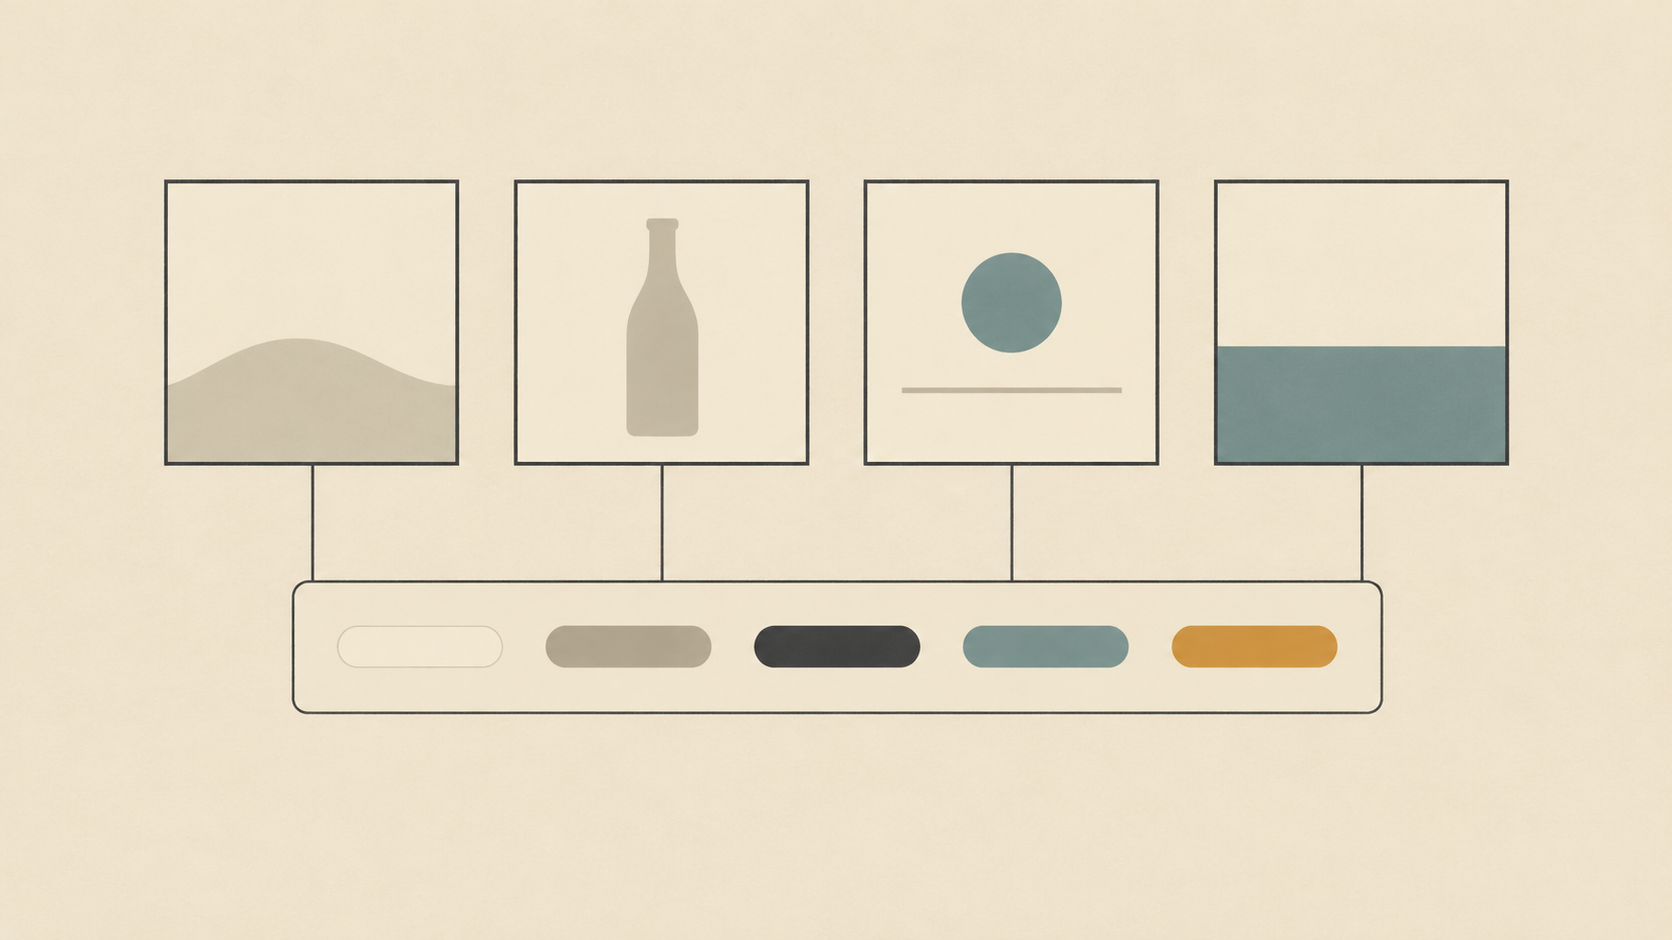
这套骨架可以通用,因为它从不提及具体主体。下面把同样的五行,填进四种常见的源图类型。
窗边人像。 锚定:相同的裁切,相同的柔和侧光。动作:她朝窗户方向微微转头,然后安定下来。运镜:固定。节奏:第一秒几乎静止,转头在第三秒前完成,一直保持到结尾。冻结清单:发际线和背景线条不变,嘴闭合,没有手。小动作才是重点——几度的转头读起来像活着,而整个身体的转身会给模型时间去凭空造出第二张脸。
无缝背景上的产品。 锚定:相同的居中构图,相同的地面投影。动作:瓶子旋转不超过 15 度,让标签接住光。运镜:极缓慢推近。节奏:旋转立刻开始,推近匀速持续到最后一帧。冻结清单:标签文字保持清晰可读,没有反光扫过标签,没有漂浮颗粒。产品短片最先败在文字上,所以这里的冻结清单承担了大部分工作。
冒着热气的一杯饮品。 锚定:相同的杯子、相同的桌沿、相同的逆光。动作:热气向上卷起并变淡;水珠停在原处。运镜:固定。节奏:连续,无缓入缓出,整条片子运动均匀。冻结清单:没有倾倒,没有新的冰块,液体不流动。环境运动是最容易做对的一类,因为主体本身不需要改变——只有它周围的空气在动。
室内或风景。 锚定:相同的地平线,相同的取景。动作:窗帘轻轻摆动;远处的叶子有细微位移。运镜:向右缓慢横移。节奏:从第一帧到最后一帧速度恒定。冻结清单:地平线保持水平,没有新家具,没有人。这是运镜真正有价值的一种情况,因为当摄影机移动时,带有前景、中景和背景的画面会分离成层次——正是这个效果让一张平面照片有了三维感。
只做一个运镜决定,而不是三个
运镜这一句是提示词最容易用力过猛的地方。Getimg 对电影感 AI 运镜的拆解把道理讲得很干净:七种标准运动——推近、拉远揭示、侧向跟移、环绕、俯仰揭示、摇臂上升、手持跟随——每一种只干一件特定的事,选对一种比叠加好几种更重要。他们对常见故障的诊断很准确:结果出现随机的变焦、不稳定的漂移,或者一台没有方向的漂浮摄影机,原因就是根本没有做出运镜决定。
由此有两条实际后果。第一,除了运动,还要点明速度,因为只说“推近”,出来的可能是一记猛冲。第二,检查源画面能否承载你想要的运动。横移或环绕需要有纵深可供揭示;在一张所有元素都在同一平面上的扁平画面里,没有任何东西可以分离,同样的运动看起来就只是平移。如果你的照片是扁平的,就选推近,让主体动作去撑起整条片子。
按症状读片,然后只改一句
当一条片子没打中,人总想全部重写。忍住。几乎每一种失败都对应骨架里的某一句,改那一句只需要十秒钟。
- 整个画面在漂移或在“呼吸”:锚定或运镜那句太含糊。加上“固定机位、三脚架锁死画面”,并重申原始取景。
- 人脸在帧与帧之间换了个人:同时发生的事情太多。锁死摄影机,把动作削减到一个微小的运动。
- 所有东西一起动,包括本该静止的东西:冻结清单缺失或太抽象。点名那些必须待在原处的元素。
- 看起来像幻灯片式变焦,毫无生气:节奏那句缺席,运动被均匀摊平。给动作一个开始、一个结束和一段保持。
- 冒出新的物体或一双手:冻结清单需要一条硬性否定——“没有手进入画面,没有新物体,没有添加文字。”
- 片子结尾崩掉或循环得很糟:最后一秒从来没写。说明最后一帧是什么样,并在那里剪断。
段落要短,用剪辑代替延长
生成本身在设计上就是短的,而延长一条片子容易累积小错误:脸变软、标签扭曲、背景长出原本不存在的细节。规划几段干净的素材,而不是一个长镜头。为每一段写同样的五行,只改动动作和运镜幅度,然后在运动的节拍点上把它们剪接起来。结果读起来是一个序列,而不是一个逐渐劣化的单镜头。
在哪里跑这套骨架
KOOX AI 的 Wan 2.6 图生视频生成器 正是围绕这种分工构建的:你提供源图,然后描述运动、运镜方向和氛围,不断迭代直到片子符合目标。页面明确说明,原始图像的作用是在加入运动的同时保持主体身份、取景和构图稳定——这就是锚定那一句,只不过它由工具来保证,而不是靠你的措辞。
如果你更想从手头已有的照片出发,而不是新生成一帧,照片转视频 工具采用同样的三步结构,并且在图像清晰、光线充足、主体可见时效果最好。如果你想在运镜语言上比单一运动走得更远,五种镜头配方 讲的是如何导演一个短序列,而不是一条片子。
六十秒起飞前检查
在点下生成之前,读一遍你的提示词,回答五个问题。取景锁定了吗?有且只有一个可见动作吗?有且只有一个运镜决定,并且带速度吗?运动被排进时间表了吗?有一份不能改变或不能出现的东西的清单吗?
五个“是”,你就得到了一条可以调试的提示词。一个“否”,你就知道在下一次生成之前该改哪一句。这套骨架不是好点子的配方——它的作用是让你能从结果判断出,问题出在你的点子上,还是出在你的措辞上。