Seedance AI 视频故障排查:六种症状与背后对应的提示词写法
面向 Seedance AI 视频的症状优先排查法:成片里的每一种瑕疵分别指向提示词中的哪一处,以及消除它的最小改动。
大多数让人失望的 Seedance 片段,问题并不出在文笔上。它们只是写错了顺序,或者描述的是一种氛围,而模型需要的却是一个镜头。文生视频的好处在于,成片同时也是一份诊断报告:镜头运动时画面扭曲,指向的是那句运镜描述;同一个道具在两个镜头之间变了样,指向的是你给这个道具起的名字;一句对白被淹没在多余的字幕之下,指向的是音频段落。以这种方式去读产出,大多数修复都只需要一句话。
这是一遍以症状为先的检查,而不是一堆模板。每一节都指出一样你在播放器里看得见的现象、它背后的提示词习惯,以及消除它所需的最小改动。参照依据是 ByteDance 为 Seedance 系列模型提供的官方指导,以及在实际测试中验证这些内容的公开提示词指南。
Seedance 提示词有两层,出错的方式各不相同
Runway 的 Seedance 指南把提示词描述为各司其职的两层。外层是结构层:片段被拆成带编号的镜头,按事件发生的顺序书写,于是模型在知道内容之前先知道了节奏。内层是描述层:在每个镜头内部,连续的句子交代画面里有谁、他们在做什么、在哪里、处于什么光线之下,以及摄影机如何运动。
Fuser 在总结 ByteDance 自己的材料时,给内层排出了一个值得记住的顺序:主体与动作,然后是场景与环境,然后是视觉风格,然后是运镜与镜头切换,然后是声音,最后是一行约束条件。Runway 的示例用八个要素覆盖了同样的范围,并在结尾给出画质、风格,以及一条关于字幕和水印的反向指令。
下面几乎每一种失败,都是这两层中的某一层出了问题。没有镜头规划的提示词,会变成一段毫无区分的漂移。没有描述层的提示词,产出的画面在技术上是动的,里面却没有一个值得看的人。当你打开一个糟糕的片段时,先判断自己面对的是哪一层,因为两者的修复位置在提示词的不同部分。
症状一:画面很美,却几乎不动
你要的是“电影感、情绪化、高细节、浅景深”,得到的却是一张会呼吸的照片。风格词以四比一的比例压过动作词,于是模型把外观渲染了出来,动作则靠临场发挥,而它发挥出来的动作又小又谨慎。
修复的办法是把笔墨花在一个动作上,给它速度和力度,并把它落在一个身体部位上。Runway 的示例正是这么做的:一位陶艺师用双手稳住碗沿,缓缓地。副词承担节奏,双手承担动作,于是没有什么需要猜。如果主体是产品而不是人,就写明它做的那一个动作,比如旋转三十度,并说明周围有什么保持静止。
症状二:镜头运动时画面发生形变
这是 Seedance 最常见的瑕疵,也是最不神秘的一种。ByteDance 针对 Seedance 2.0 的指导提醒,同时要求推、拉、摇和移动,会加剧画面不稳定。四条指令争抢同一个画面,于是边缘拖影、直线弯曲、人脸失去几何结构。
规则是每个镜头只有一个运动,第二种运动应该放进第二个镜头,而不是塞进同一句话。如果你需要一个以特写收尾的推镜,就只写这个推镜,让景别自己收束;或者标出镜头 1 和镜头 2,各给一条运镜描述。修复的另一半,是用模型已经能读懂的影视术语来交代摄影机:景别、角度,以及一个运动,而不是用一整段暗示运动却始终不点明的氛围描写。
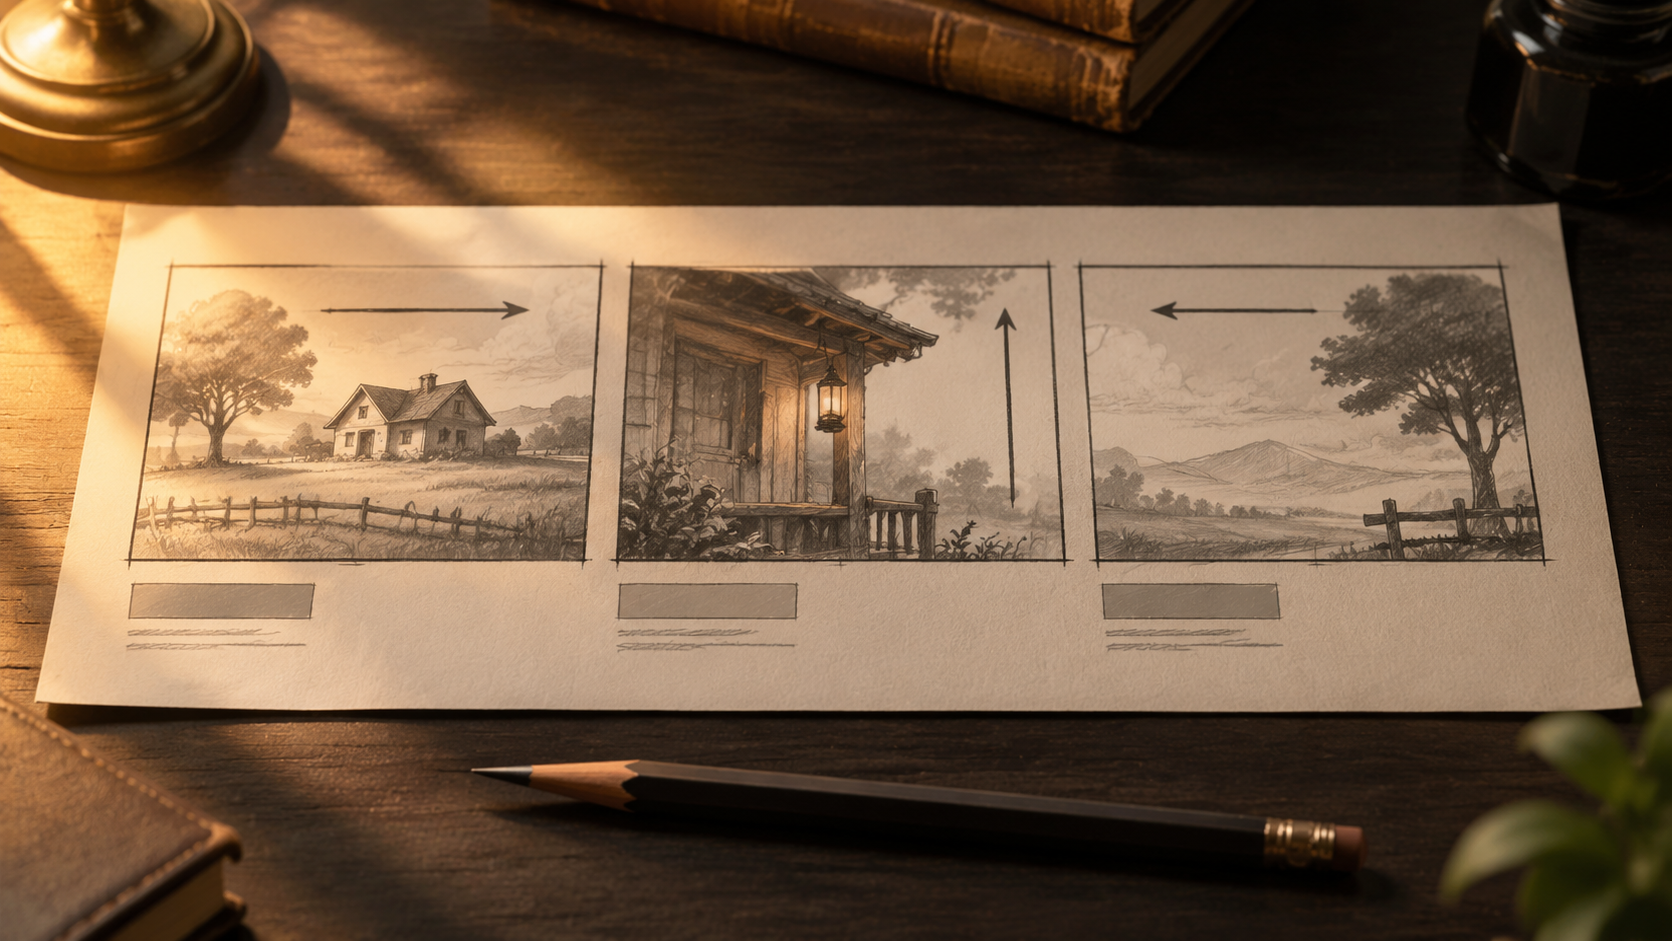
症状三:剪辑点出现在你没要求的地方
一句写着“两秒时她转身、四秒时镜头切到全景”的提示词,假定模型会看时钟。ByteDance 的 Seedance 2.0 指南说,它响应的是镜头编号而不是精确时长,并提醒强行指定精确时长可能导致生成结果异常。更晚的 2.5 代则能读取整数秒区间,比如第零到第二秒的镜头,那是另一套约定。
所以诊断取决于你在给哪个版本写提示词。如果你的提示词塞满了逐秒指令,而片段凭空多出剪辑点或整段吞掉了该有的节拍,那就是在给一个只想要镜头编号的模型排过密的日程。给镜头编号,把节拍按发生顺序放好,让节奏自己收束。如果你用的版本确实读时间戳,就让时间线保持连续、不留空档,也不要把一个区间塞得太满,以至于模型不得不加一个剪辑点才能把所有内容装进去。
症状四:道具在两个镜头之间变了样
Fuser 公开的测试记录是目前最干净的例子:一位陶艺师被跨两个镜头生成,陶罐在特写里是一只矮而敞口的碗,到了中景却成了一个高圆柱。提示词在两个镜头之间改掉了对这件物体的描述,而写的人没有察觉。
解决办法是命名的纪律。把一件物体只描述一次,用同一套词,在它出现的每一处都照抄,并且宁可用一份具体的清单而不是一个形容词:头梁、两个耳罩、哑光燕麦色釉面、左侧磕缺的边沿。如果这件物体在商业上重要,就附上一张图片参考,并说明它控制的是什么,而不是指望散文本身撑住。Runway 的指南还补充了一个关于人物的相关要点:一张把脸、服装、姿势和背景合在一起的图片,留给面部特征的画面比例太小,无法作为锚点,所以人脸参考首先应该是一张人脸参考。
症状五:情绪节点变成一片空白
你写的是“她看起来很自豪”,得到的却是一张皮肤质感很好、表情中性的脸。自豪、悲伤、紧张这类词描述的是内在状态,里面没有任何东西是渲染器能落到画面上的。Runway 的指导在这一点上很直接:把情绪表现为身体行为。
把这个节点改写成一个有起点、有终点的可见动作。她的肩膀垂下来。他呼出一口气,把视线移开镜头。她的手停在半途,落在桌面上。同一条规则也能救产品视频:“高级感”无法渲染,但一道光缓缓扫过拉丝金属的边缘可以。
症状六:对白下面多出你没要的字幕
在画面与声音同一次生成出来的那些 Seedance 代次上,声音属于提示词的内部,而不是事后追加的另一个段落。Fuser 记录了 ByteDance 的括号约定:尖括号表示音效,花括号表示对白,圆括号表示音乐,非中文的台词要在前面注明语种。
造成字幕问题的有两种习惯。第一种是重复台词里的词,或者给单个词打上情绪标记,指导里把这列为触发多余屏幕文字的诱因。把表演提示挂在说话人身上,而不是挂在那句台词上。第二种是把约束留成隐含的:用一句直白的指令收尾,说明片段不带字幕、不带标志和水印,并且完全不要让密集的文字排版出现在提示词里,字幕留到后期去重建,在那里修改不需要重新渲染。
多个症状同时出现时,按正确的顺序修
一次改掉所有东西,你什么也学不到,因为你无法把新的结果归因于任何一处单独的改动。不妨按这个顺序来。
从身份开始:主体、道具,以及保护它们的特征描述句。如果主体不稳定,后面的一切都无从判断。然后是运镜,因为形变的画面会掩盖其他所有问题。接着是时间与镜头数量,因为剪辑点的多少决定了音频有多少空间可用。最后才是声音和约束。
一份值得花三十秒的渲染前清单
- 主体只被命名一次,之后通篇用同一个称谓指代。
- 每个镜头只有一个动作,并且写明了速度和力度。
- 每个镜头只有一次运镜,且用影视术语写明。
- 镜头按事件发生的顺序编号。
- 出现两次的物体,两次的描述完全一致。
- 情绪写成身体行为。
- 声音放在对应的括号里,并注明语种。
- 最后一行去掉字幕、标志和水印。
把这套排查用到真实片段上
如果界面提供种子(seed),在整轮修复中都把它固定住,这样对比隔离出来的是你的改动,而不是采样噪声。先生成短的、先审,等五秒版本站得住再延长时间;更长的片段要保住更多状态,而一次失败的长序列会丢掉更大的一块工作量。
诊断式排查的意义在于,它让第二次渲染比第一次更便宜。你不再重写整段提示词,而是开始只改一句话,然后把两个片段并排放在你追查的那个症状上比较。这样来回两三遍,通常就能得到一个站得住的片段,以及一份可以留给下一个产品或下一个场景复用的提示词。
你可以在 KOOX 的 Seedance 视频生成器 上跑这套流程,先从较短的时长和单个镜头开始,再决定要不要做带剪辑点的更长序列。把提示词版本、参数设置和检查笔记放在一起,哪一句话导致哪种瑕疵的规律就会变成你自己的东西,而不是每次都要重新推导。