Image-to-Video-Prompts: ein Fünf-Zeilen-Gerüst, das jedes Standbild trägt
Ein Gerüst aus fünf Zeilen für Image-to-Video-Prompts – Anker, Aktion, Kamera, Tempo und Sperrliste – mit ausgearbeiteten Beispielen für vier Arten von Ausgangsfotos und einem Leitfaden vom Symptom zur Korrektur.
Ein Image-to-Video-Prompt ist keine Beschreibung einer Szene. Die Szene steht bereits auf deinem Bildschirm: die Farbe des Mantels, das Licht am Fenster, die Form des Glases, der exakte Bildausschnitt. Was ein Standbild dem Modell nicht sagen kann, ist, was als Nächstes passieren soll – und genau dafür lohnt es sich, Worte auszugeben.
Die meisten enttäuschenden Clips entstehen aus Prompts, die dem Modell das Foto noch einmal beschreiben. Zehn Adjektive über eine Frau im roten Mantel geben dem Generator nichts, was er animieren könnte – also liefert er seine eigene Drift, seinen eigenen Zoom, sein eigenes langsames Schwanken. Die Prompts, die halten, sind kürzer und strukturierter: eine Zeile, die den Frame fixiert, eine, die eine einzige sichtbare Aktion benennt, eine für die Kameraentscheidung, eine für das Tempo und eine, die auflistet, was sich nicht verändern darf.
Was das Standbild bereits entschieden hat
Ein Ausgangsfoto kommt mit einem Großteil des Prompts bereits beantwortet an. Das Motiv ist gewählt, das Licht hat eine Richtung, die Komposition hat einen Ausschnitt, und die Farbpalette steht fest. Der Prompt-Leitfaden von Kling legt ein sechsteiliges Gerüst vor – Motiv, Aktion, Szene, Kamera, Licht, Stimmung –, und wenn du ein Standbild animierst, sind vier dieser sechs Teile bereits in der Datei sichtbar. Wirklich offen sind nur Aktion und Kamera, und die Stimmung ergibt sich meist aus dem Licht, das du ohnehin nicht ändern kannst.
Deshalb sollte ein Image-to-Video-Prompt deutlich kürzer sein als ein Text-to-Video-Prompt. Die Prompt-Bibliothek von Founderz formuliert dieselbe Anforderung aus der Gegenrichtung: Ein guter KI-Videoprompt benennt eine sichtbare Aktion, die Einstellung und die Kamerabewegung, das Licht, die Dauer und das, was sich nicht verändern darf. Beim Standbild ist das Licht vorgegeben. Die anderen vier Punkte liegen bei dir.
Behandle den Prompt also als Bewegungsbudget. Jeder Satz, den du für das Nacherzählen des Bildes ausgibst, ist ein Satz, den du nicht für die Veränderung ausgibst, und das Modell füllt diese Lücke mit generischer Bewegung: ein langsamer Push, den niemand verlangt hat, ein Flimmern über den ganzen Frame, ein Motiv, das zu atmen beginnt, obwohl es stillstehen sollte.
Das Gerüst aus fünf Zeilen
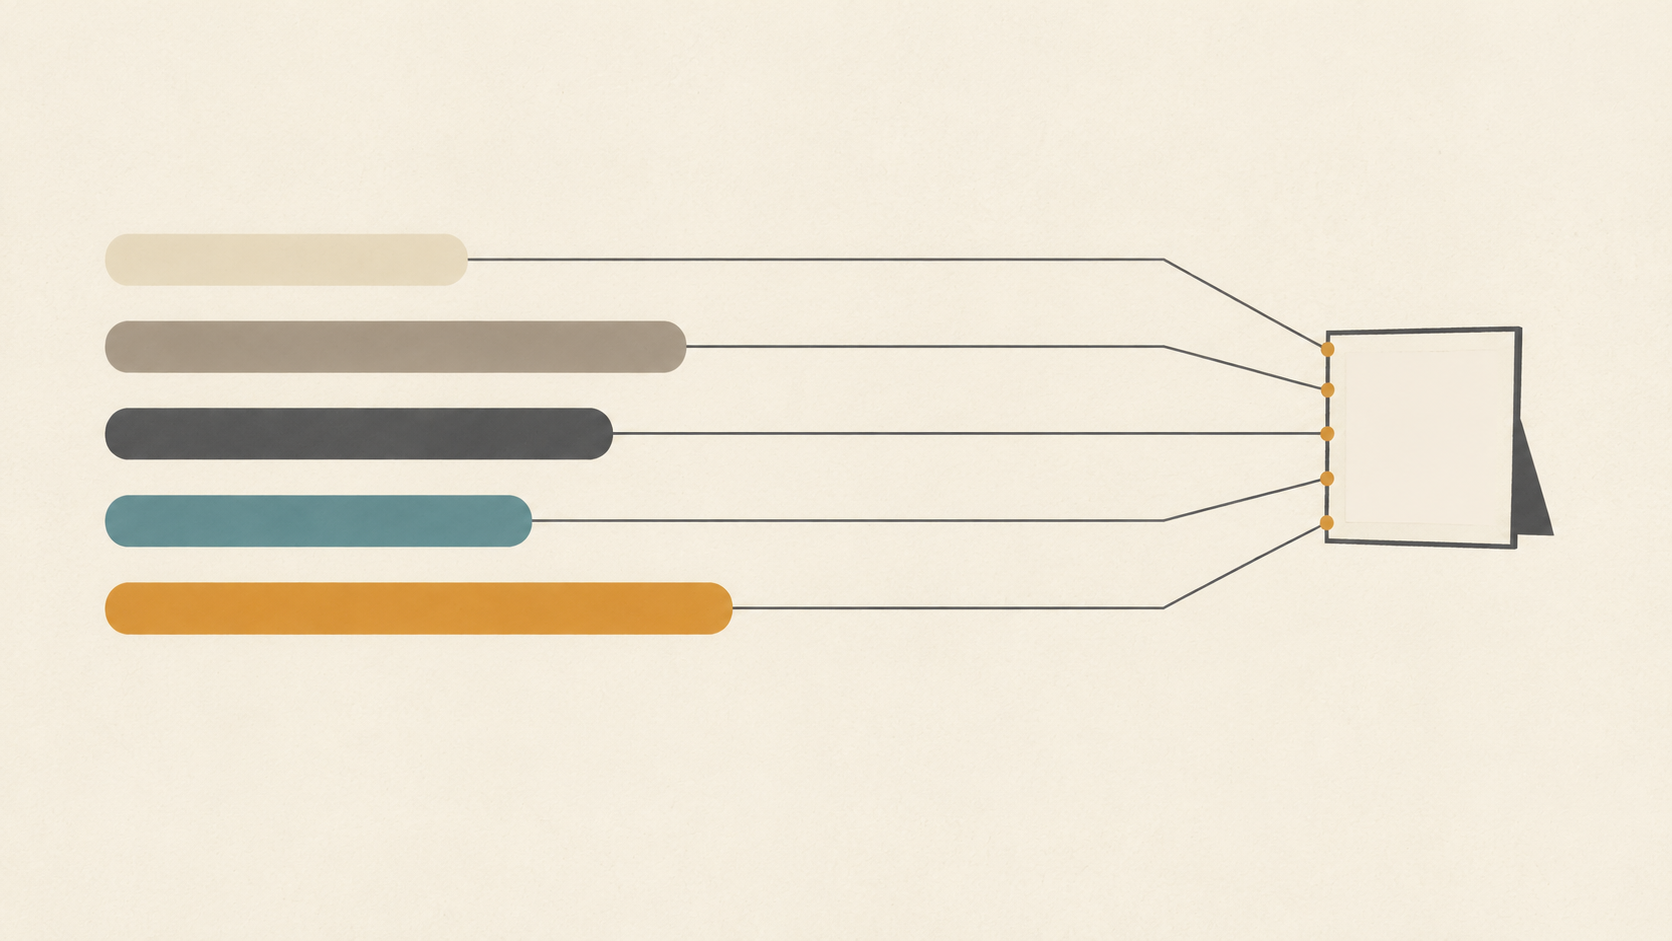
Schreibe fünf Zeilen in dieser Reihenfolge. Zusammen ergeben sie etwa vierzig bis sechzig Wörter, was für einen Clip von wenigen Sekunden die richtige Größe ist.
- Anker. Fixiere, was das Modell nicht neu gestalten darf: „gleicher Bildausschnitt, gleiche Linse, gleiches Licht wie im Ausgangsbild“. Ohne Anker behandelt das Modell das Foto als Vorschlag und komponiert es neu – daher kommen abweichende Ausschnitte und kippende Horizonte.
- Aktion. Ein sichtbares Verb, an ein Motiv gebunden: „sie dreht den Kopf ein paar Grad zum Fenster und hält inne“. Eine Aktion, keine Abfolge. Zwei Aktionen in einem Clip bedeuten meist, dass keine davon zu Ende kommt.
- Kamera. Benenne eine Bewegung und ihr Ausmaß: „langsamer Push-in, am Ende etwa zehn Prozent näher, zentriert auf das Etikett“. Wenn die Einstellung keine Kamerabewegung braucht, sag es ausdrücklich – „statische Kamera“ ist eine gültige und oft bessere Anweisung.
- Tempo. Binde die Aktion an die Zeit: „fast still in der ersten Sekunde, die Drehung ist bis zur dritten abgeschlossen, die letzte Sekunde hält“. Modelle dehnen Bewegung standardmäßig über den ganzen Clip, was wie eine konstante langsame Drift wirkt; mit einem Zeitplan wirkt die Bewegung bewusst.
- Sperrliste. Die Dinge, die sich nicht verändern dürfen oder nicht auftauchen dürfen: „das Etikett bleibt zur Kamera gerichtet und bleibt scharf, keine Hände kommen ins Bild, keine neuen Objekte, der Mund bleibt geschlossen“. Negative Erwartungen funktionieren nur, wenn sie konkret sind.
Lies die fünf Zeilen in dieser Reihenfolge, und du hast einen Shot-Plan, der in eine Textnachricht passt. Lies sie in anderer Reihenfolge oder lass eine weg, kannst du meist vorhersagen, welcher Fehler entsteht.
Vier Fotos, ein Gerüst
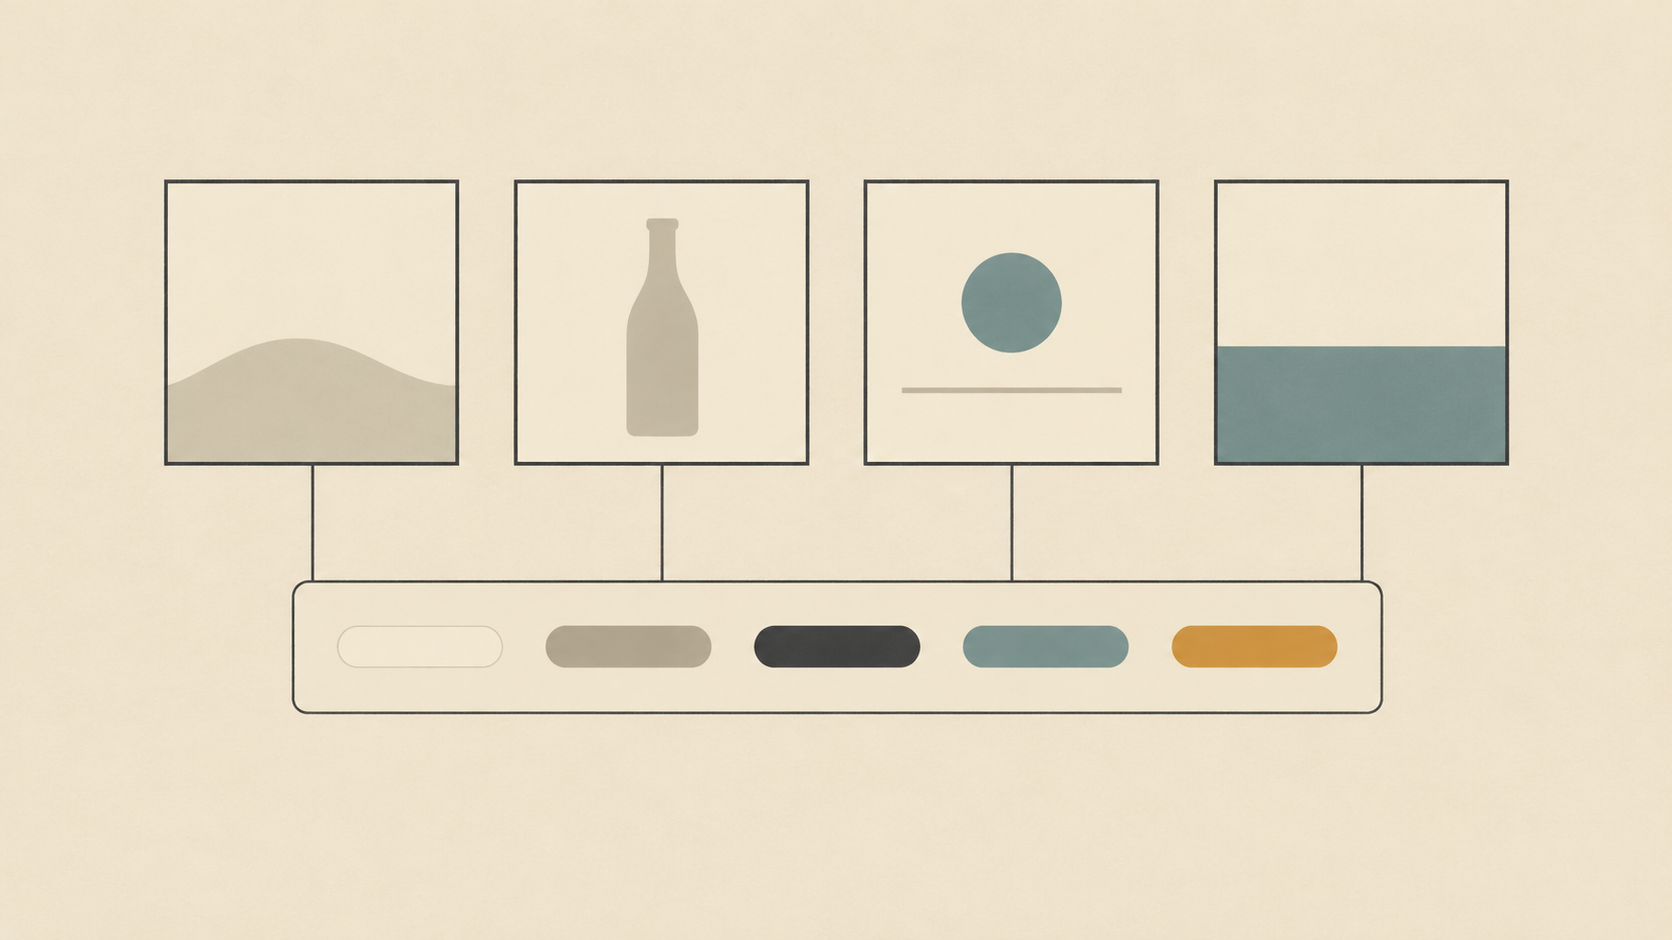
Das Gerüst ist übertragbar, weil es nie ein Motiv nennt. Hier sind dieselben fünf Zeilen für vier häufige Arten von Ausgangsbildern ausgefüllt.
Ein Porträt am Fenster. Anker: gleicher Ausschnitt, gleiches weiches Seitenlicht. Aktion: sie dreht den Kopf leicht zum Fenster und kommt zur Ruhe. Kamera: statisch. Tempo: fast still in der ersten Sekunde, die Drehung endet bis zur dritten, halten bis zum Schluss. Sperrliste: gleicher Haaransatz und gleiche Hintergrundlinie, Mund geschlossen, keine Hände. Die kleine Aktion ist der Punkt – eine Kopfdrehung um wenige Grad wirkt lebendig, während eine ganze Körperdrehung dem Modell Zeit gibt, ein zweites Gesicht zu erfinden.
Ein Produkt vor nahtlosem Hintergrund. Anker: gleiche zentrierte Komposition und gleicher Schatten auf der Oberfläche. Aktion: die Flasche dreht sich um höchstens fünfzehn Grad, damit das Etikett das Licht einfängt. Kamera: sehr langsamer Push-in. Tempo: die Drehung beginnt sofort, der Push läuft gleichmäßig bis zum letzten Frame. Sperrliste: der Text auf dem Etikett bleibt scharf und lesbar, kein Reflex wandert über das Etikett, keine schwebenden Partikel. Produktclips scheitern zuerst am Text, deshalb leistet die Sperrliste hier die meiste Arbeit.
Ein Getränk mit sichtbarem Dampf. Anker: gleiches Glas, gleiche Tischkante, gleiches Gegenlicht. Aktion: Dampf kräuselt nach oben und wird dünner; Kondenswasser bleibt, wo es ist. Kamera: statisch. Tempo: durchgehend, ohne Easing, Bewegung gleichmäßig über den ganzen Clip. Sperrliste: kein Einschenken, kein neues Eis, keine Bewegung der Flüssigkeit. Umgebungsbewegung ist die einfachste Art, weil das Motiv selbst sich nicht ändern muss – nur die Luft darum herum.
Ein Interieur oder eine Landschaft. Anker: gleicher Horizont und gleicher Bildausschnitt. Aktion: der Vorhang bewegt sich leicht; entfernte Blätter verschieben sich. Kamera: langsame seitliche Drift nach rechts. Tempo: konstante Geschwindigkeit vom ersten bis zum letzten Frame. Sperrliste: der Horizont bleibt waagerecht, keine neuen Möbel, keine Menschen. Das ist der eine Fall, in dem eine bewegte Kamera ihren Platz verdient, weil ein Frame mit Vordergrund, Mittelgrund und Hintergrund sich in Schichten aufteilt, während die Kamera fährt – der Effekt, der ein flaches Bild dreidimensional wirken lässt.
Eine Kameraentscheidung, nicht drei
Die Kamerazeile ist der Punkt, an dem Prompts meist zu viel wollen. Die Analyse filmischer KI-Kamerabewegungen von Getimg argumentiert das sauber: Jede der sieben Standardbewegungen – Push-in, Pull-back-Reveal, seitliches Tracking, Orbit, Tilt-Reveal, Kranfahrt, Handheld-Follow – erfüllt eine bestimmte Aufgabe, und die richtige zu wählen ist wichtiger, als mehrere zu stapeln. Ihre Diagnose des häufigen Fehlers ist präzise: Das Ergebnis bekommt einen zufälligen Zoom, eine instabile Drift oder eine Kamera, die ohne Richtung schwebt, weil überhaupt keine Kameraentscheidung getroffen wurde.
Daraus folgen zwei praktische Konsequenzen. Erstens: Nenne neben der Bewegung auch die Geschwindigkeit, denn ein „Push-in“ allein kann als heftiger Vorstoß ankommen. Zweitens: Prüfe, ob der Ausgangs-Frame die gewünschte Bewegung tragen kann. Eine seitliche Drift oder ein Orbit braucht Tiefe, um etwas freizulegen; bei einem flachen Frame, in dem alles auf einer Ebene liegt, gibt es nichts zu trennen, und dieselbe Bewegung wirkt wie ein Schwenk. Ist dein Foto flach, wähle einen Push-in und lass die Aktion des Motivs den Clip tragen.
Den Clip nach Symptom lesen, dann eine Zeile korrigieren
Wenn ein Clip danebengeht, liegt die Versuchung darin, alles neu zu schreiben. Widerstehe ihr. Fast jeder Fehlschlag lässt sich auf eine einzelne Zeile des Gerüsts zurückführen, und diese Zeile zu korrigieren ist eine Sache von zehn Sekunden.
- Der ganze Frame driftet oder atmet: Die Anker- oder Kamerazeile ist vage. Ergänze „statische Kamera, stativfester Frame“ und wiederhole den ursprünglichen Bildausschnitt.
- Das Gesicht wechselt zwischen den Frames die Identität: Es passiert zu viel gleichzeitig. Friere die Kamera ein und reduziere die Aktion auf eine kleine Bewegung.
- Alles bewegt sich gleichzeitig, auch Dinge, die stillstehen sollten: Die Sperrliste fehlt oder ist zu abstrakt. Benenne die Elemente, die an ihrem Platz bleiben.
- Es sieht aus wie ein Slideshow-Zoom ohne Leben: Die Tempozeile fehlt, deshalb verteilt sich die Bewegung gleichmäßig. Gib der Aktion einen Anfang, ein Ende und ein Halten.
- Ein neues Objekt oder ein Paar Hände taucht auf: Die Sperrliste braucht eine harte Verneinung – „keine Hände kommen ins Bild, keine neuen Objekte, kein zusätzlicher Text“.
- Der Clip bricht am Ende zusammen oder die Schleife sitzt schlecht: Die letzte Sekunde wurde nie geschrieben. Sag, wie der letzte Frame aussieht, und schneide dort.
Segmente kurz halten und schneiden statt verlängern
Die Generierung ist von Natur aus kurz, und das Verlängern eines Clips sammelt tendenziell kleine Fehler an: Das Gesicht wird weicher, das Etikett verzieht sich, der Hintergrund bekommt Details, die nie da waren. Plane lieber eine Handvoll saubere Segmente als eine lange Einstellung. Schreibe dieselben fünf Zeilen für jedes Segment und ändere nur die Aktion und das Kameramaß, dann schneide sie auf einem Bewegungsbeat zusammen. Das Ergebnis liest sich als Abfolge statt als einzelne Einstellung, die verfällt.
Wo du das Gerüst einsetzt
Der Wan-2.6-Image-to-Video-Generator von KOOX AI ist genau um diese Trennung herum gebaut: Du lieferst das Ausgangsbild, beschreibst dann Bewegung, Kamerarichtung und Stimmung und iterierst, bis der Clip zum Ziel passt. Die Seite sagt ausdrücklich, dass das Originalbild dazu da ist, Motividentität, Bildausschnitt und Komposition stabil zu halten, während die Bewegung hinzukommt – das ist die Ankerzeile, durchgesetzt vom Werkzeug statt von deiner Formulierung.
Wenn du lieber von einem Foto ausgehst, das du schon hast, statt einen neuen Frame zu generieren, folgt das Werkzeug zum Foto in Video umwandeln derselben dreistufigen Form und funktioniert am besten mit einem klaren, gut beleuchteten Bild und einem sichtbaren Motiv. Und wenn du tiefer in die Kamerasprache einsteigen willst als mit einer einzelnen Bewegung, führen die fünf Shot-Rezepte durch die Regie einer kurzen Sequenz statt eines einzelnen Clips.
Ein Sechzig-Sekunden-Check vor dem Start
Bevor du auf Generieren drückst, lies deinen Prompt und beantworte fünf Fragen. Ist der Bildausschnitt fixiert? Gibt es genau eine sichtbare Aktion? Gibt es genau eine Kameraentscheidung, mit Geschwindigkeit? Ist die Bewegung zeitlich getaktet? Gibt es eine Liste der Dinge, die sich nicht ändern dürfen oder nicht auftauchen dürfen?
Fünfmal Ja, und du hast einen Prompt, den du debuggen kannst. Ein Nein, und du weißt, welche Zeile du bearbeiten musst, bevor du eine weitere Generierung daran verschwendest. Das Gerüst ist keine Formel für eine gute Idee – es ist das, was dir am Ergebnis zeigt, ob deine Idee oder deine Formulierung das Problem war.