串联 AI 图像转换轮次:何时从上一轮结果继续,何时回到原图重做
多轮 AI 图像转换的实操流程:读懂 strength 与步数之间的换算关系,判断何时该从原始照片重做,维护一份轮次台账,并从效果最好的一轮导出。
大多数 AI 图像转换都是从一张照片、一处改动开始的。改动生效了,结果也算拿得出手,于是第二个念头冒出来:把背景调暖一点、把角落清干净、把阴影再柔化一些。这时候,多数人会把上一轮的结果重新喂回去,再提一个要求。也正是在这一刻,一次受控的编辑变成了串联,而串联的表现和单次处理完全不是一回事。
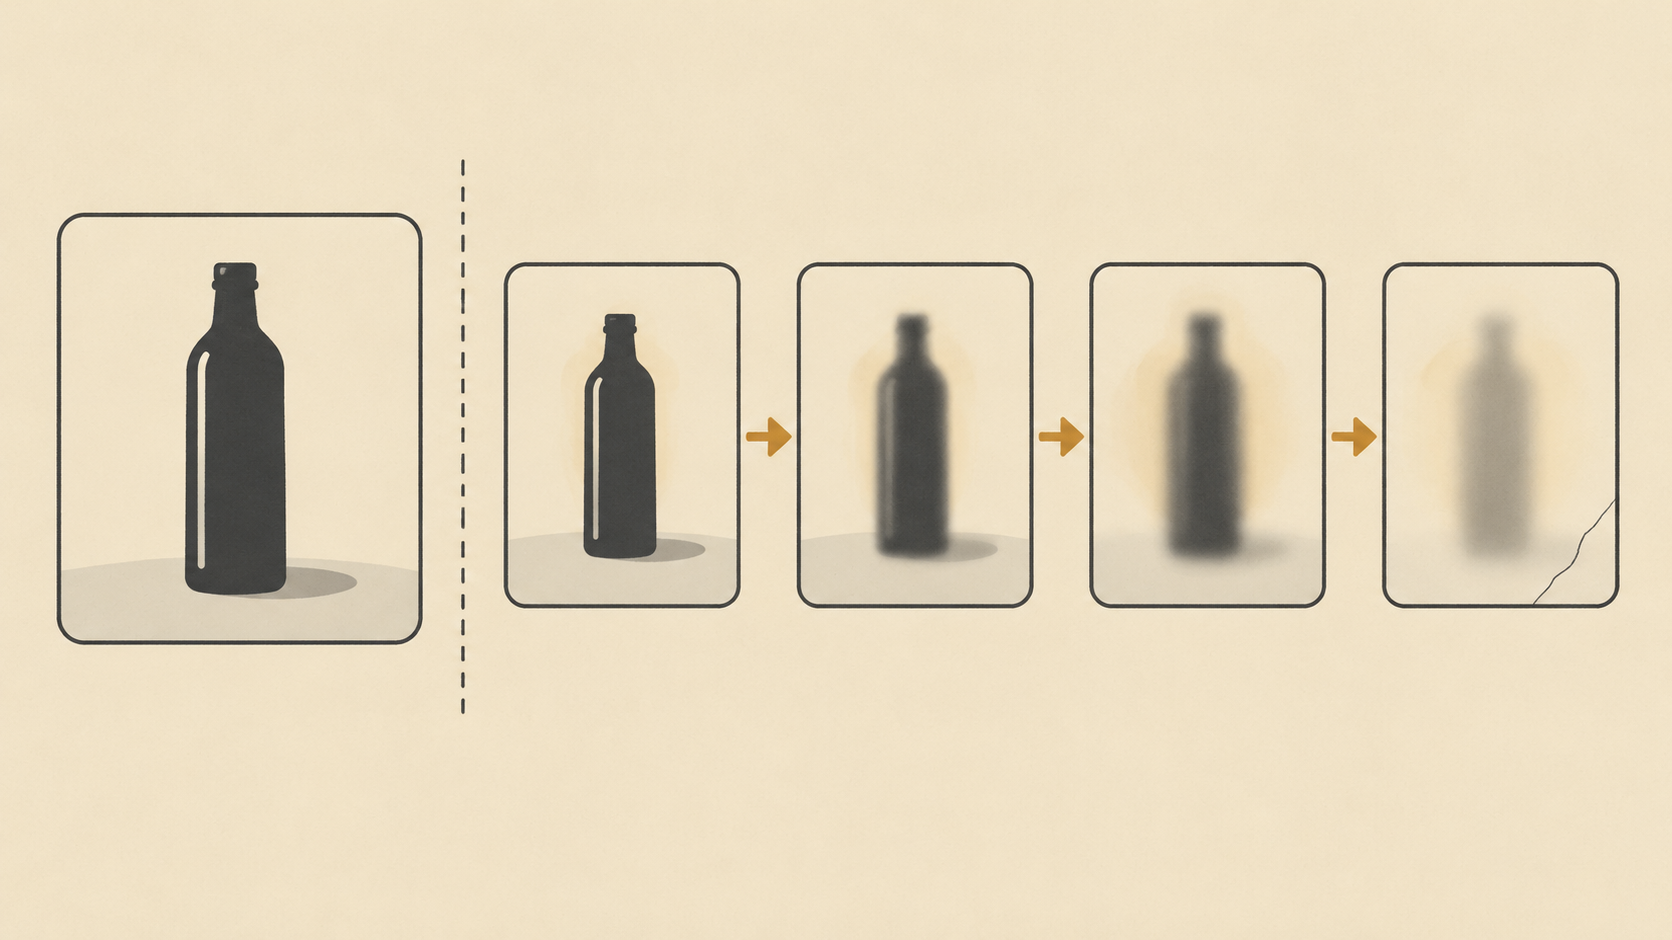
第二个要求本身没有什么不合理。变的是起点。第一轮里,模型从一张照片出发,而照片是对真实场景的密集记录。第二轮里,它从一张生成的图像出发——那是对同一场景的一次可信重建;第三轮则从一次重建的重建出发。每一环单独看都没有问题。问题在于,每一轮都会重新解释那些本就只是近似出来的细节,而这些微小的重新解释会朝同一个方向累积。
第二遍处理和第一遍不是同一件事
第一次转换有一张照片作为锚点。织物的褶皱、石材的颗粒、阴影的确切色调、标签在高光下贴合的方式:这些全都来自你上传的那个文件。它们是测量出来的,不是凭空想出来的。
一旦你把生成的图像传回去,锚点就没了。此时模型把上一轮的输出当作“世界”本身,包括其中那些略有偏差的部分:被柔化掉的瓶身边缘、角度不对的反射、悄悄丢了扣环的背带。第二遍处理并不知道这些是错误。它把它们保留下来,有时还会把它们强化成一种风格。
这就是为什么同一个提示词在第一轮效果漂亮,到了第二轮却可能产出更浑浊的东西。指令没有变差,是指令底下的真值变薄了。
串联之前,先读懂 strength 的换算
基于扩散模型的图生图不是图层编辑。Diffusers 的图生图文档把这个过程说得很直白:起始图像先被编码,然后加噪,模型再去噪、朝你的提示词方向还原。strength 决定这张图要走完这段路程的多大比例。数值越高,模型越有余地去做出不一样的东西;到 1.0 时,起始图像基本上被忽略。数值越低,输出就越贴近你带进来的那张图。
文档还点明了很多人漏掉的耦合关系:strength 和 num_inference_steps 是一起起作用的,strength 决定了实际施加多少步加噪。在 50 步、strength 为 0.8 的情况下,这 50 步里有 40 步是重新加噪、重新去噪的。所以一次 0.8 的“温和”第二遍处理,仍然是在重建画面的五分之四。图像看起来相似,是因为提示词要求的是相似的东西,而不是因为像素被保护住了。
正是这套算术让串联变得昂贵。两次 0.8 不是 1.6 轮的改动;它们是两次完整的重建,而且第二次是建在一次重建之上的。guidance_scale 从另一侧放大了这个效应:数值越高,越用力地把结果拉向提示词的措辞,留给起始图像反驳的余地就越小。
判断该继续,还是该重来
有用的问题不是上一次的结果看起来有多好,而是下一个改动究竟碰到哪里。这个答案会把活儿分成两堆。
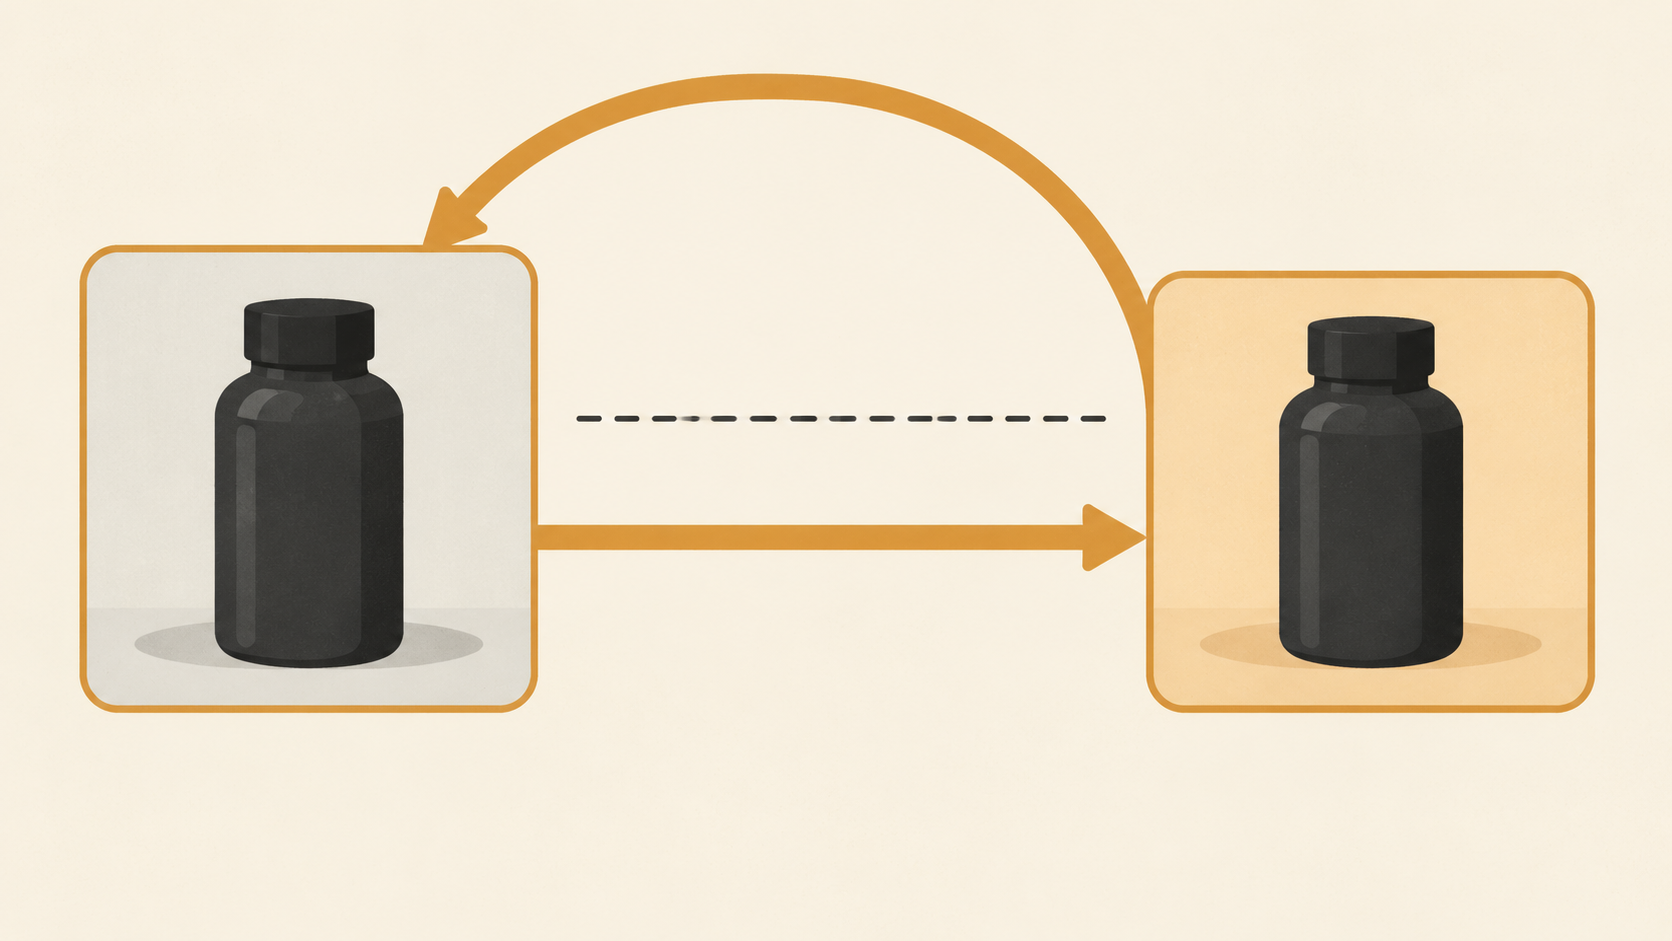
如果下一个改动涉及主体,就从原始照片重来:轮廓、比例、扣环、标签、主体与背景相接的边缘、任何小字,或者产品的准确颜色。这些正是第二次生成最容易先糊掉的细节,而一旦第一遍把它们柔化了,再怎么小心写提示词也找不回来。重来意味着写一份把两处改动一起提出的说明,从干净的源图出发。
如果下一个改动是全局的、宽容的,那么从上一轮输出继续是站得住脚的:整幅画面的色温偏移、背景的整体罩色、对比度略微增减、清理一个没有重要东西的空角落。这些改动不需要主体的原始像素,因为它们不碰主体。
给自己一个实用的上限会有帮助:允许自己从照片出发做两轮结构性改动,而不是一轮接一轮地叠加。如果关于主体的第三个念头来了,它应该进入一份从第零轮重新写起的说明里,和前两个并列,而不是摞在它们上面。
保留一份真值文件,外加一份台账
串联是悄悄失败的,因为记忆总是先失效。三天之后,没人记得七个文件里哪一个是好的,也没人记得它是哪个提示词产出的。
用两个小习惯解决它。第一,绝不要覆盖原始上传的文件:把它当作只读的第零轮保留,每一轮都导出为新文件,文件名里带上轮次编号。第二,在文件旁边维护一份台账,每轮一行:轮次编号、起始输入、提示词、strength、guidance 数值,以及一句话说明这一轮是为了什么。
台账做两件事。它告诉你后面某一轮更差时该退回哪一轮,也告诉你全都行不通时该改什么。没有它,迭代就变成一串互不相关的猜测,只是碰巧放在同一个文件夹里。
把每一轮写成一处改动加一份保护
一轮串联的处理之所以效果最好,是因为提示词同时点明要改什么、以及什么必须活下来。只给一条指令的提示词,会让模型随意重新解释它没有提到的一切——而在第二轮里,那等于一切。
Google 的图像生成文档在它的编辑示例里展示了这种形状:提示词先点名唯一的目标,然后把画面其余部分封住——只把蓝色沙发换成复古的棕色皮革切斯特菲尔德沙发,房间其余部分,包括抱枕和灯光,保持不变。它只有一句话,却包含了一处改动和一份保护清单。
写串联的一轮时,也照这个方式写,并让保护清单具体指向上一轮做对的地方。如果第一轮终于做出了可信的阴影,就在提示词里说出来。如果瓶子的标签完整地活了下来,就把它点名。这份清单不是装饰;它是指令里阻止下一次生成把自由度花在你已经付过代价的细节上的那部分。
在基于某一轮继续之前,先逐轮检查
一旦开始串联,检查的问题就变了。它不再是“这个够好了吗”,而是“这是一个可以安全地在上面继续的基础吗”。以原始尺寸看每一个结果,而不是在缩略图网格里看,并在同样的缩放比例下与第零轮对比。
串联开始出问题时,有三个征兆会早早出现。边缘变软:主体与背景的交界失去锐利,蒙上一层淡淡的光晕。质感变平:石材变光滑,织物丢掉织纹,重复的细节变成图案。小特征漂移:标签偏移几个像素,反射改变角度,阴影改变方向。只要这些出现在你在意的细节上,当前文件就是下一轮的糟糕输入,不管它在别的方面做得多对。
从最好的一轮收尾,而不是最新的一轮
串联里的最后一张图几乎从来不是最好的那张,因为你之所以继续往下做,正是因为还有哪里不对。导出之前,把各轮并排放在一起,挑最扎实的那个文件,而不是最新的那个。
然后就别再动它了。如果后面某一轮解决了最好那一轮弄错的一块区域,只取那一块,或者把这项改进并进那份获胜的说明、从原始照片重新跑一遍。两种做法都比继续串下去干净,也都保留了回到源图的路。
完全不该使用串联的场景
有些活儿完全容不下第二次重建。要求物品与实物完全一致的产品摄影、带可读文字的包装、logo,以及任何要过平台审核的东西,都不适合串联。每一遍都是重新生成,而不是图层编辑,所以精确到像素不是提示词能保证的事情。
当要求的是保持同一性时,就从原图一次做完转换,最后几个百分点交给能保留抠图的合成工具完成。这种分工也正是 KOOX 早前那篇关于在再次迭代之前先检查一次转换的指导所指的方向:用眼睛判断,然后一次只改一处。
一份今天就能跑的流程
从一张你熟悉的照片开始,给它一处你能用一句话说清的改动。把这一轮存为第一轮,配一行台账。在提任何新要求之前,先判断下一个改动属于哪一堆:主体——意味着从源图重新开始并写一份合并的说明;还是氛围——可以从第一轮继续。
把串联控制在两轮以内,每个结果都按原始尺寸与原图对照检查,导出最好的那个文件而不是最后一个。如果你想在开始串联之前先看看这套流程里单次处理的那一端,AI 图生图工具就是跑第零轮的地方。
串联本身不是错误。它是一项有预算的技术,而这份预算付掉的是那些在缩略图尺寸下看不见的细节的保真度。