多镜头序列的 AI 视频运动提示词:一套 Kling 3 工作流
一套用于 Kling 3 多镜头场景中 AI 视频运动提示词的实用工作流:先规划镜头覆盖,再分配秒数,每个镜头只写一个节拍,最后审查剪切点。
运动提示词通常是逐个镜头写的:选一个主体,选一个运动,生成,然后根据镜头是否照做来评判结果。Kling 3 改变了工作的单位。VIDEO 3.0 系列中的一次生成最多可以容纳六个镜头、跨越三到十五秒,自行规划转场,并让原生音频贯穿每一次剪切。问题不再是镜头做了什么,而是每个镜头把它的秒数花在了什么上,以及剪切必须落在哪里,下一个节拍才讲得通。
这首先是规划问题,其次才是措辞问题。下面的工作流把一次生成当作一个小序列:先建立镜头覆盖,在镜头之间分配秒数,用同一种方式写每个镜头块,锚定不能改变的东西,然后审查剪切点而不是漂亮的画面。这一切都能放进一个提示词输入框。
先建立镜头覆盖,再写运动
镜头覆盖就是镜头清单,以及每个镜头负责什么。先用朴素的句子写出来,不要用镜头语言:画面上是谁,观众由此知道的那一件事。一个四镜头的饮品短片读起来是这样的:台面上孤零零的玻璃杯;一只手把它拿起;倒酒;杯子被放下。到这一步之后,每一行才配上一个取景。
Kling 自己的多镜头指南在这一点上很严格。每个镜头都应该增加一个独特的视觉或叙事节拍,而不是从另一个角度重复已经给过的信息。仅这一条规则就能淘汰大多数糟糕的镜头清单。如果两行告诉观众的是同一件事,其中一行就是伪装成节拍的镜头运动。把它们合并,或者让第二行说一件新的事。
把清单控制在模型能规划的范围内。官方功能表列出,在自动和自定义两种模式下,每次生成最多六个镜头。六是上限,不是目标。
先分配秒数,再动笔写一个字
VIDEO 3.0 系列生成三到十五秒的片段,而在 Custom Multi-Shot 中,每个镜头的时长由你自己设定。这两点把提示词变成了一道除法题。九秒配三个镜头,暗示每个三秒。六个镜头塞进六秒,每个节拍只有一秒,这连让观众看清一个新画面都不够,更不用说表演了。
有两条规则经得起与模型的实际接触。把最长的时间给承载变化的那个镜头,并让最短的镜头保持在两秒及以上,除非那是刻意的闪切。如果算下来低于这个下限,说明这个片段里你的镜头太多了:砍掉一个节拍,而不是把每个镜头都压缩。
把秒数写进提示词。模型读得懂这个结构,而你也得到了一份可以用来对照输出的计划。
用同样的四个槽位写每一个镜头块
每个块都是一叠短句,顺序相同:镜头编号与时长、取景、主体动作、镜头行为。对白或声音提示放在最后,归它所属的那个镜头所有。Kling 的指南列出了同样的字段——时长、取景与视角、叙事内容、镜头运动——这说明该顺序并非随意。
纪律比词汇更重要。每个镜头一个可见的运动,而且它应该与主体的动作一致:人物向镜头迈步,配上缓慢推近,两者互相放大;而向镜头迈步配上拉远,则互相抵消。像“电影感”这样的形容词命名的是一种感觉,而不是一个决定,所以它们只花掉字数,却约束不了任何东西。
一个写完的块读起来是这样的。镜头二,三秒,侧面中景,她举起杯子并倒酒,镜头随她的手向右漂移。一个取景,一个动作,一个运动。审片的人一眼就能看出输出是否对得上。
锚定剪切之间不能改变的东西
连贯性来自两处:你引用的东西,和你重复的东西。Kling 3 支持主体与元素引用,因此角色、产品或道具可以在角度变化时被锁定。当一个场景依赖于同一张脸或同一个标签时,一个引用比三句描述更有用。
另一半是文本层面的。为服装、道具颜色、一天中的时段和镜头质感保留一个固定的描述块,在每个出现这些东西的镜头里逐字重复它,然后只改变可变的部分。每个镜头块都被当作一条独立的指令来读,所以你在镜头三里漏掉的任何细节,都是模型可能重新编造的东西。
也要把连贯性写进动作里。如果镜头一结束时一只手握着杯子,镜头二就应该以这只手仍握着杯子开场。小小的重叠让剪切有东西可以承接。
把音频节拍放进拥有它的那个镜头
3.0 系列在生成画面的同时生成原生音频,在多角色场景中,你可以把一句台词绑定到特定的说话人。按镜头使用这一点,而不是在结尾写一段配乐描述。台词属于看得见嘴的那个镜头;环境底噪属于这个房间里的每一个镜头。
有两个限制塑造了写法。3.0 的音频是单声道,所以“左”和“右”这样的词毫无意义。对白在 Kling 为该系列列出的语言中是可靠的——中文、英语、日语、韩语和西班牙语——所以用其他语言写脚本是赌博,而不是计划。
静默是一个有效的节拍。一个没有台词、只有持续环境底噪的镜头,对节奏的帮助往往胜过一句硬塞进两秒的话。
用自动模式校准,然后接管控制
Kling 提供两种模式,按顺序使用效果最好。开启 Multi-Shot 而不动 Custom Multi-Shot 时,模型自己规划转场和取景。使用 Custom Multi-Shot 时,你设定镜头数量和时长,它会紧密跟随你的计划。
即使你打算掌控一切,也先用自动模式跑一遍你的场景描述。这是廉价的探查:你能看到模型想在哪里剪,它把哪个节拍当作建立镜头,以及你那四行是不是其实只有两行。然后再切换到 Custom Multi-Shot,写下你真正想要的计划,并带上你除法算出的时长。
自动模式这一遍还会回答这个场景到底需不需要剪切。如果模型把你的清单压缩成一个好镜头,那这个序列大概只是一个镜头加上多余的字。
审查剪切点,而不是画面
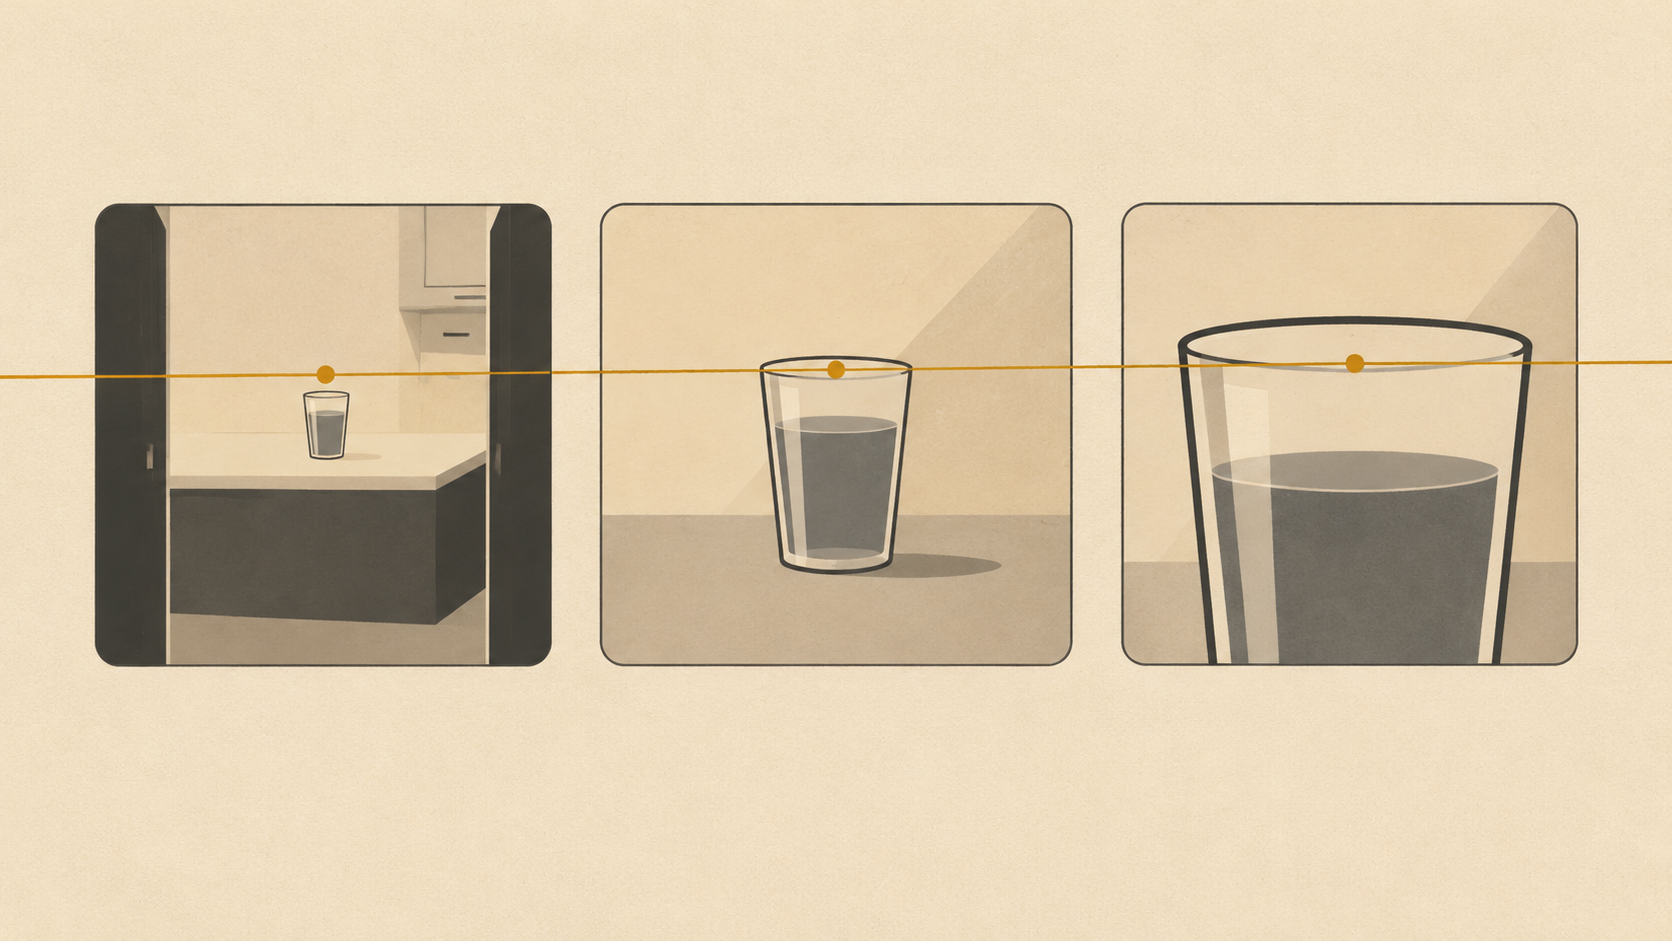
像剪辑师那样审查输出,看接点。在每个剪切点两侧各暂停几帧,问三个问题。主体是否保持了位置和朝向,还是跳到了另一边?进入的镜头是在出去的动作结束之前就开始,还是把它重来一遍?最后一个镜头停留的时间够不够看清?
大多数真实的失败都是四种之一。重复的节拍,每次剪切都复位到中性画面的镜头,折返回去的动作,或者在最后三分之一就没想法了的片段。每一种都有对应的提示词修法。重复意味着覆盖计划里有重复项。镜头复位意味着进入的镜头从未得到运动。折返意味着两个相邻的块描述了同一个手势。平淡的结尾意味着最后一个块没有属于自己的节拍。
每次迭代只改一个块。每拍一条就重写整个提示词,会让你根本无法知道是哪条指令修好了什么。
一个可改编的三镜头、九秒提示词
把下面这段当作模板,而不是剧本。在任何镜头块之前,先说一次场景和风格:黎明时分安静的厨房,温暖的窗光,浅景深。
镜头一,三秒,门口全景,房间里空无一物,只有台面上的玻璃杯,镜头静止。
镜头二,三秒,侧面中景,一只手入画并举起杯子,镜头随这只手向右漂移。
镜头三,三秒,杯沿贴近嘴唇的特写,喝一口,然后杯子放下、离开画面,镜头静止。
最后以连贯性指令收尾:自始至终同一只杯子,同一束光,同一套服装。
每个块都写明了时长、取景、一个动作和一种镜头行为。没有任何重复。时长相加等于片长,最后一个镜头保持静止,这样视频不会在一个动作中途结束。
这套工作流在 KOOX AI 上如何运行
KOOX AI 上的 Kling 3 接收一段提示词和一张可选的参考图,返回一段短片段,提示词承载场景、镜头和情绪。该页面描述的是与本工作流相同的循环:描述、生成、审查、改进。你可以在任何地方写镜头清单——笔记里或客户简报里——然后把各个块粘贴到提示词输入框。
如果你还在琢磨单镜头的运动、还没开始把它们编排成序列,一张照片的六种运动模式 会教给你每个镜头块所依赖的词汇。编排序列是第二项技能。
从三个镜头、九秒开始。做出一个每一次剪切都名副其实的序列,你就有了一个可复用的计划,适用于你尝试的每一段更长的片子。